day13 内置函数和推导式
今日概要:
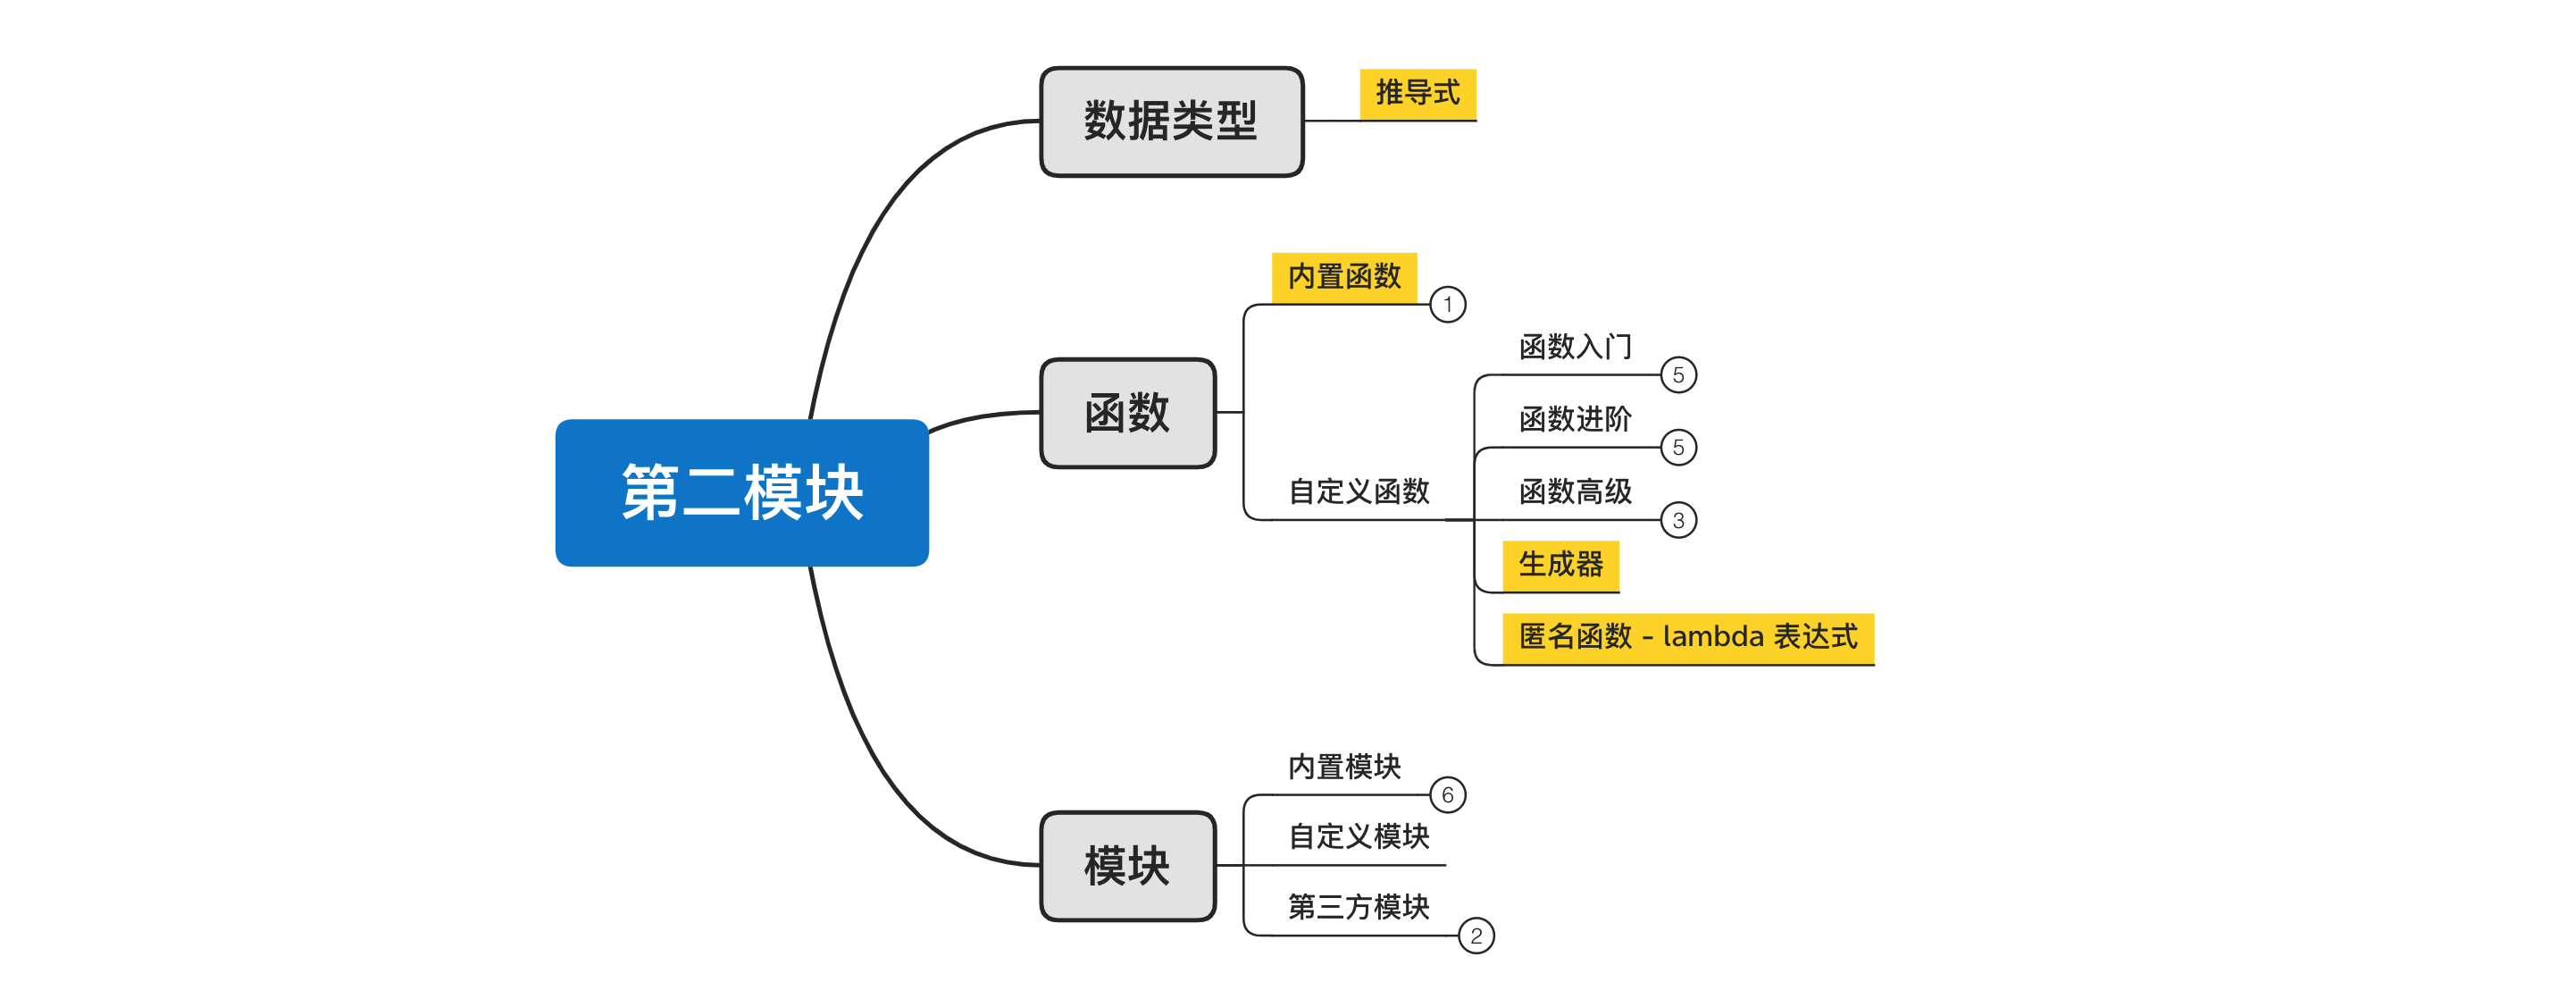
- 匿名函数
- 生成器
- 内置函数
- 附加:推导式,属于数据类型的知识,内部的高级的用法会涉及到【生成器】和【函数】的知识。
1. 匿名函数
传统的函数的定义包括了:函数名 + 函数体。
def send_email():
    pass

# 1. 执行
send_email()
# 2. 当做列表元素
data_list = [send_email, send_email, send_email ]
# 3. 当做参数传递
other_function(send_email)
匿名函数,则是基于lambda表达式实现定义一个可以没有名字的函数,例如:
基于Lambda定义的函数格式为:lambda 参数:函数体
- 参数,支持任意参数。
- 函数体,只能支持单行的代码。
- 返回值,默认将函数体单行代码执行的结果返回给函数的执行这。
匿名函数适用于简单的业务处理,可以快速并简单的创建函数。
练习题
根据函数写写出其匿名函数的表达方式
def func(data):
    name_list = data.replace(".")
    return name_list[-1]

func = lambda data: data.replace(".")[-1]
在编写匿名函数时,由于受限 函数体只能写一行,所以匿名函数只能处理非常简单的功能。
扩展:三元运算
简单的函数,可以基于lambda表达式实现。
简单的条件语句,可以基于三元运算实现,例如:
num = input("请写入内容")
data = "臭不要脸" if "苍老师" in num else "正经人"
print(data)

# 结果 =  条件成立时    if   条件   else   不成立
lambda表达式和三元运算没有任何关系,属于两个独立的知识点。
掌握三元运算之后,以后再编写匿名函数时,就可以处理再稍微复杂点的情况了,例如:
func = lambda x: "大了" if x > 66 else "小了"

v1 = func(1)
print(v1) # "小了"

v2 = func(100)
print(v2) # "大了"
2. 生成器
生成器是由函数+yield关键字创造出来的写法,在特定情况下,用他可以帮助我们节省内存。
- 生成器函数,但函数中有yield存在时,这个函数就是生产生成器函数。
- 生成器对象,执行生成器函数时,会返回一个生成器对象。
def func():
    print(111)
    yield 1
print(222)
yield 2
print(333)
yield 3
print(444)
data = func()
# 执行生成器函数func,返回的生成器对象。
# 注意:执行生成器函数时,函数内部代码不会执行。
def func():
    print(111)
    yield 1

    print(222)
    yield 2

    print(333)
    yield 3

    print(444)
data = func()
v1 = next(data)
print(v1)
v2 = next(data)
print(v2)
v3 = next(data)
print(v3)
v4 = next(data)
print(v4) # 结束或中途遇到return,程序爆:StopIteration 错误
生成器的特点是,记录在函数中的执行位置,下次执行next时,会从上一次的位置基础上再继续向下执行。
应用场景
-
假设要让你生成 300w个随机的4位数,并打印出来。
-
在内存中一次性创建300w个
- 动态创建,用一个创建一个。
import random

data_list = []
for i in range(300000000):
    val = random.randint(1000, 9999)
  data_list.append(val)

# 再使用时,去 data_list 中获取即可。
# ...
import random

def gen_random_num(max_count):
    counter = 0
    while counter < max_count:
        yield random.randint(1000, 9999)
        counter += 1

data_list = gen_random_num(3000000)
# 再使用时,去 data_list 中获取即可。
- 假设让你从某个数据源中获取300w条数据(后期学习操作MySQL 或 Redis等数据源再操作,了解思想即可)。
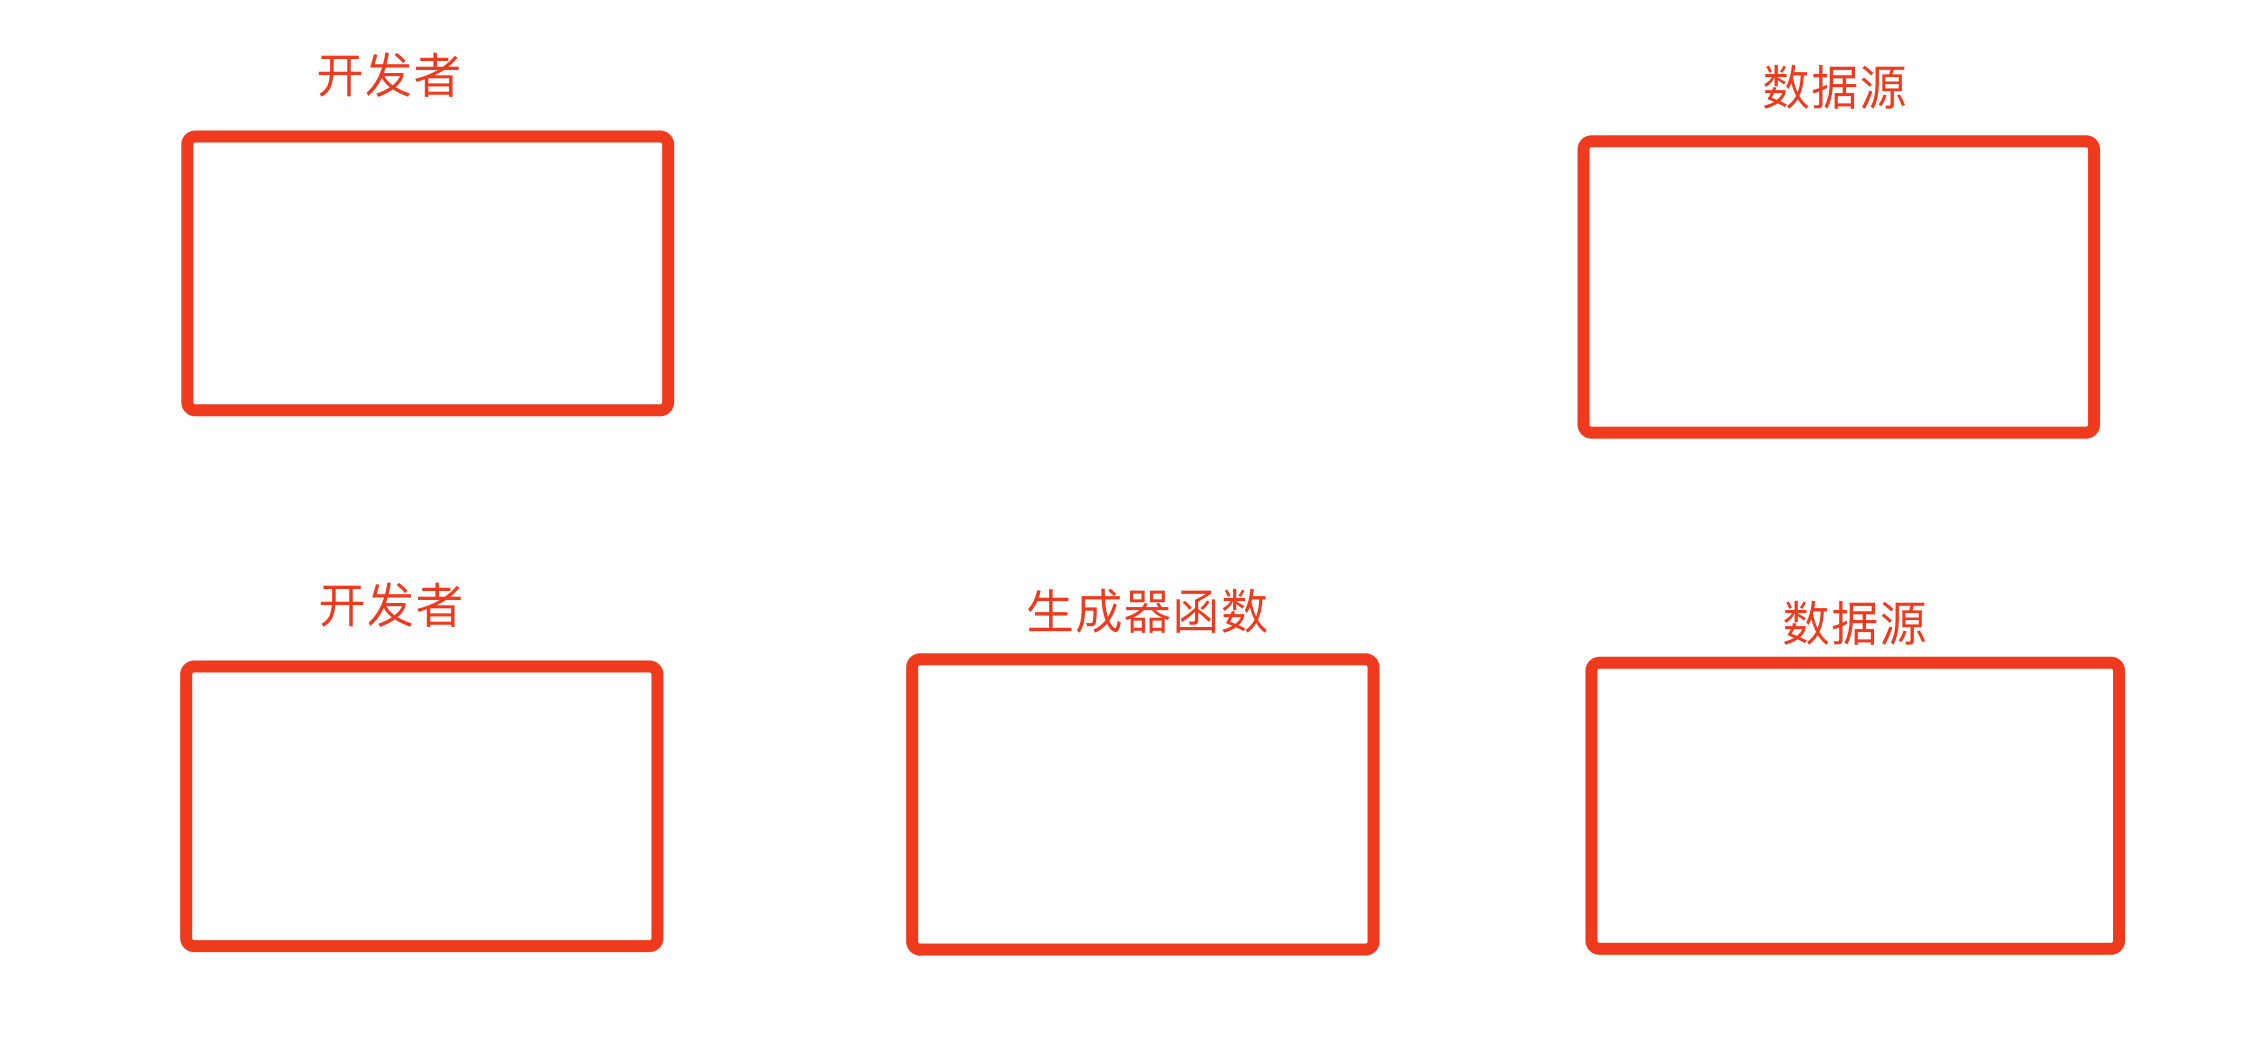
所以,当以后需要我们在内存中创建很多数据时,可以想着用基于生成器来实现一点一点生成(用一点生产一点),以节省内存的开销。
扩展
def func():
    print(111)
    v1 = yield 1
    print(v1)

    print(222)
    v2 = yield 2
    print(v2)

    print(333)
    v3 = yield 3
    print(v3)

    print(444)

data = func()
n1 = data.send(None)  #第一次传必须是None 执行到 yield 1,把1赋值给了n1 暂定了, 还没赋值给v1
print(n1)

n2 = data.send(666)  # v1 = 666   print(v1)  print(222)  2返回给n2
print(n2)            # 2

n3 = data.send(777)
print(n3)

n4 = data.send(888)
print(n4)

# send 是把值传给 yield 前面的变量
3.内置函数
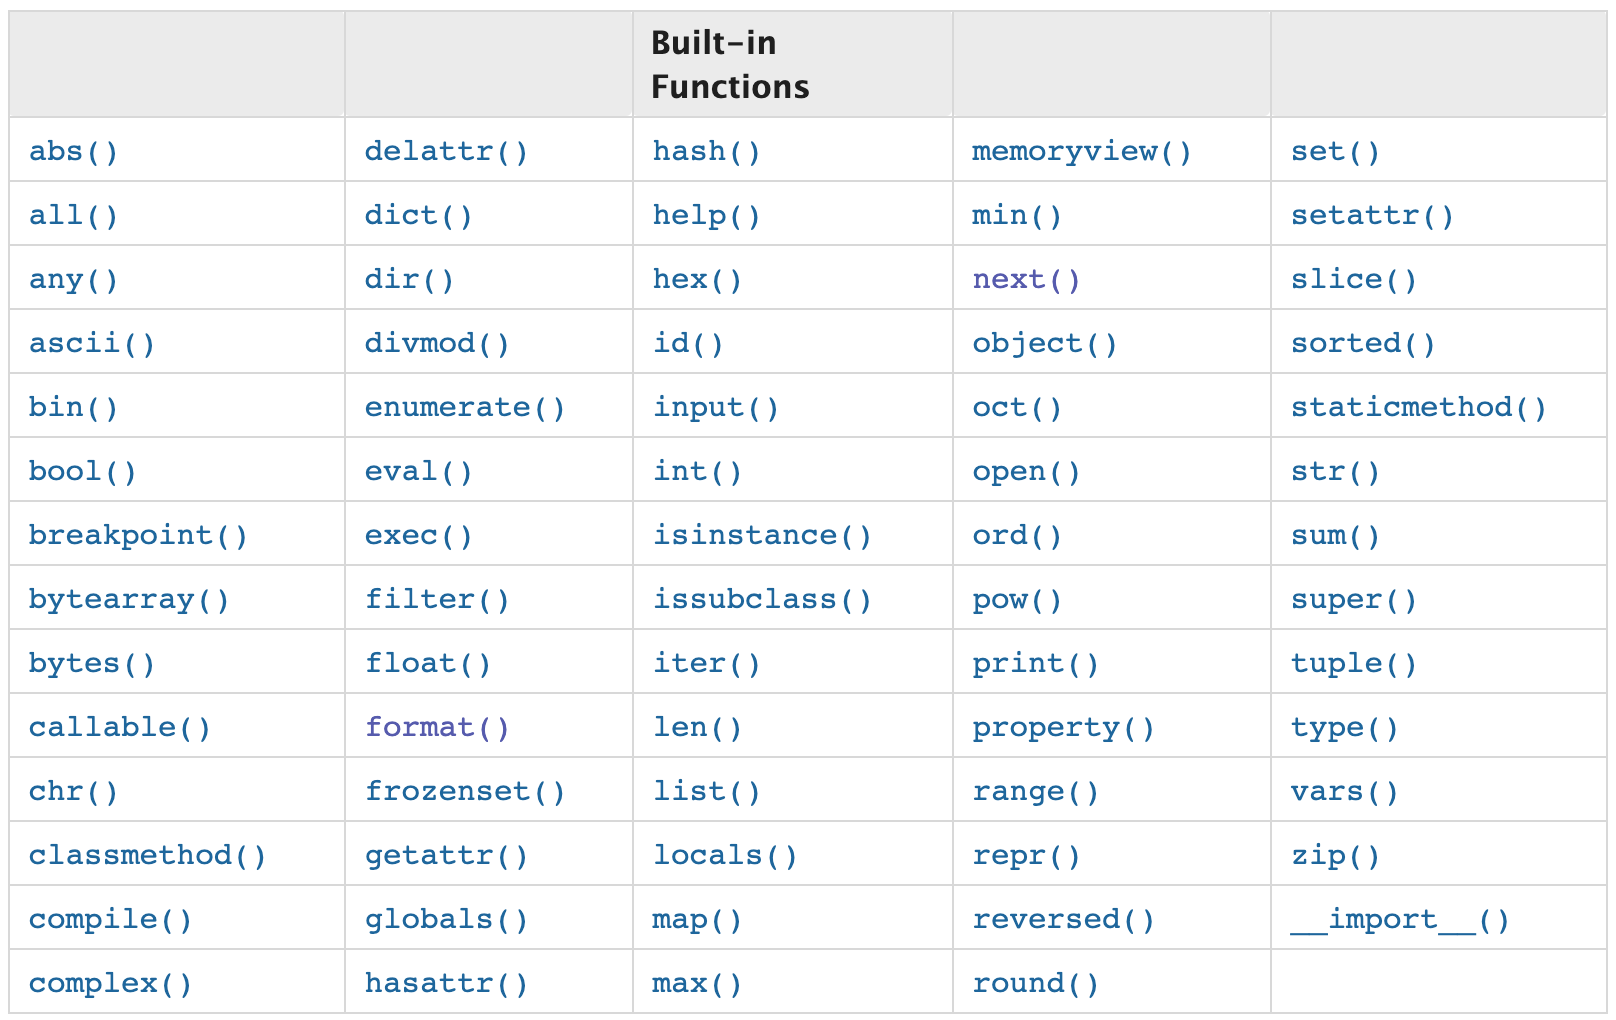
Python内部为我们提供了很多方便的内置函数,在此整理出来36个给大家来讲解。
-
第1组(5个)
-
abs,绝对值
-
pow,指数
-
sum,求和
-
divmod,求商和余数
-
round,小数点后n位(四舍五入)
-
第2组:(4个)
-
min,最小值
-
max,最大值
-
all,是否全部为True
-
any,是否存在True
-
第3组(3个)
-
bin,十进制转二进制
- oct,十进制转八进制
-
hex,十进制转十六进制
-
第4组(2个)
-
ord,获取字符对应的unicode码点(十进制)
-
chr,根据码点(十进制)获取对应字符
-
第5组(9个)
-
int
-
foat
-
str,unicode编码
-
bytes,utf-8、gbk编码
-
bool
-
list
-
dict
-
tuple
-
set
-
第6组(13个)
-
len
-
print
-
input
-
open
-
type,获取数据类型
-
range
-
enumerate
-
id
-
hash
-
help,帮助信息
- pycharm,不用
- 终端,使用
-
zip
-
callable,是否可执行,后面是否可以加括号。
-
sorted,排序
info = {
    "wupeiqi": {
        'id': 10,
        'age': 119
    },
    "root": {
        'id': 20,
        'age': 29
    },
    "seven": {
        'id': 9,
        'age': 9
    },
    "admin": {
        'id': 11,
        'age': 139
    },
}

result = sorted(info.items(), key=lambda x: x[1]['id'])
print(result)
data_list = [ '1-5 编译器和解释器.mp4', '1-17 今日作业.mp4', '1-9 Python解释器种类.mp4', '1-16 今日总结.mp4', '1-2 课堂笔记的创建.mp4', '1-15 Pycharm使用和破解(win系统).mp4', '1-12 python解释器的安装(mac系统).mp4', '1-13 python解释器的安装(win系统).mp4', '1-8 Python介绍.mp4', '1-7 编程语言的分类.mp4', '1-3 常见计算机基本概念.mp4', '1-14 Pycharm使用和破解(mac系统).mp4', '1-10 CPython解释器版本.mp4', '1-1 今日概要.mp4', '1-6 学习编程本质上的三件事.mp4', '1-18 作业答案和讲解.mp4', '1-4 编程语言.mp4', '1-11 环境搭建说明.mp4' ] result = sorted(data_list, key=lambda x: int(x.split(' ')[0].split("-")[-1]) ) print(result)
4.推导式
推导式是Python中提供了一个非常方便的功能,可以让我们通过一行代码实现创建list、dict、tuple、set 的同时初始化一些值。
请创建一个列表,并在列表中初始化:0、1、2、3、4、5、6、7、8、9...299 整数元素。
- 列表
num_list = [ i for i in range(10)]

num_list = [ [i,i] for i in range(10)]

num_list = [ [i,i] for i in range(10) if i > 6 ]
- 集合
num_set = { i for i in range(10)}

num_set = { (i,i,i) for i in range(10)}

num_set = { (i,i,i) for i in range(10) if i>3}
- 字典
num_dict = { i:i for i in range(10)}

num_dict = { i:(i,11) for i in range(10)}

num_dict = { i:(i,11) for i in range(10) if i>7}
- 元组,不同于其他类型。
# 不会立即执行内部循环去生成数据,而是得到一个生成器。
data = (i for i in range(10))
print(data)
for item in data:
    print(item)
练习题
- 去除列表中每个元素的
.mp4后缀。
data_list = [
    '1-5 编译器和解释器.mp4',
    '1-17 今日作业.mp4',
    '1-9 Python解释器种类.mp4',
    '1-16 今日总结.mp4',
    '1-2 课堂笔记的创建.mp4',
    '1-15 Pycharm使用和破解(win系统).mp4',
    '1-12 python解释器的安装(mac系统).mp4',
    '1-13 python解释器的安装(win系统).mp4',
    '1-8 Python介绍.mp4', '1-7 编程语言的分类.mp4',
    '1-3 常见计算机基本概念.mp4',
    '1-14 Pycharm使用和破解(mac系统).mp4',
    '1-10 CPython解释器版本.mp4',
    '1-1 今日概要.mp4',
    '1-6 学习编程本质上的三件事.mp4',
    '1-18 作业答案和讲解.mp4',
    '1-4 编程语言.mp4',
    '1-11 环境搭建说明.mp4'
]

result = []
for item in data_list:
    result.append(item.rsplit('.',1)[0])

result = [ item.rsplit('.',1)[0] for item in data_list]
- 将字典中的元素按照
键-值格式化,并最终使用;连接起来。
info = {
    "name":"武沛齐",
    "email":"xxx@live.com",
    "gender":"男",
}

data_list []
for k,v in info.items():
    temp = "{}-{}".format(k,v)
    temp.append(data_list)
resutl = ";".join(data)

result = ";".join( [ "{}-{}".format(k,v) for k,v in info.items()] )
- 将字典按照键从小到大排序,然后在按照如下格式拼接起来。(微信支付API内部处理需求)
info = {
    'sign_type': "MD5",
    'out_refund_no': "12323",
    'appid': 'wx55cca0b94f723dc7',
    'mch_id': '1526049051',
    'out_trade_no': "ffff",
    'nonce_str': "sdfdffd",
    'total_fee': 9901,
    'refund_fee': 10000
}

data = "&".join(["{}={}".format(key, value) for key, value in sorted(info.items(), key=lambda x: x[0])])
print(data)
- 看代码写结果
- 看代码写结果
def func(num):
    return num + 100

data_list = [func(i) for i in range(10)]
print(data_list) # [100,101,102,103,104,105,106,107,108,109]
- 看代码写结果(执行出错,通过他可以让你更好的理解执行过程)
- 看代码写结果(新浪微博面试题)
data_list = [lambda x: x + i for i in range(10)]  # [函数,函数,函数]   i=9  定义时候不执行函数体内容

v1 = data_list[0](100) #运行时候i=9 结果109
v2 = data_list[3](100)
print(v1, v2)  # 109 109
小高级
- 推导式支持嵌套
data = [ (i,j) for j in range(5) for i in range(10)]

data = []
for i in range(10):
    for j in range(5):
        data.append( (i,j) )

data = [ [i, j] for j in range(5) for i in range(10)]
# 一副扑克牌

poker_list = [ (color,num) for num in range(1,14) for color in ["红桃", "黑桃", "方片", "梅花"]]

poker_list = [ [color, num] for num in range(1, 14) for color in ["红桃", "黑桃", "方片", "梅花"]]

print(poker_list)
- 烧脑面试题
def num():
    return [lambda x: i * x for i in range(4)]


# 1. num()并获取返回值  [函数,函数,函数,函数] i=3
# 2. for循环返回值
# 3. 返回值的每个元素(2)
result = [m(2) for m in num()]  # [6,6,6,6]
print(result)
def num():
    return (lambda x: i * x for i in range(4)) # 元组 不会立即执行内部循环去生成数据,而是得到一个生成器。


# 1. num()并获取返回值  生成器对象
# 2. for循环返回值
# 3. 返回值的每个元素(2)
result = [m(2) for m in num()]  # [0,2,4,6 ] 循环一次生成一次
print(result)
总结
- 匿名函数,基于lambda表达式实现一行创建一个函数。一般用于编写简单的函数。
- 三元运算,用一行代码实现处理简单的条件判断和赋值。
- 生成器,函数中如果yield关键字
- 生成器函数
- 生成器对象
- 执行生成器函数中的代码
- next
- for(常用)
- send
- 内置函数(36个)
- 推导式 - 常规操作 - 小高级操作
作业
- 看代码写结果
v = [ lambda :x  for x in range(10)]
print(v)      # [function * 9]
print(v[0])   # [function]
print(v[0]()) # 9
- 看代码写结果
- 看代码写结果
data = [lambda x: x*i for i in range(10)]
print(data) # [function * 10 ] i = 9
print(data[0](2)) # 18
print(data[0](2) == data[8](2)) # True
- 请用列表推导式实现,踢出列表中的字符串,最终生成一个新的列表保存。
data_list = [11,22,33,"alex",455,'eirc']

new_data_list = [ ... ] # 请在[]中补充代码实现。

# 提示:可以用type判断类型
----------------------------------------
data_list = [11,22,33,"alex",455,'eirc']

new_data_list = [ x for x in data_list if type(x) == int ]
print(new_data_list)
- 请用列表推导式实现,对data_list中的每个元素判断,如果是字符串类型,则计算长度作为元素放在新列表的元素中;如果是整型,则让其值+100 作为元素放在新的列表的元素中。
data_list = [11,22,33,"alex",455,'eirc']

new_data_list = [ ... ] # 请在[]中补充代码实现。

# 提示:可以基于三元运算实现
---------------------------------------------
data_list = [11,22,33,"alex",455,'eirc']
new_data_list = [ len(i) if type(i) == str else i+100  for i in data_list]
print(new_data_list)
- 请使用字典推导式实现,将如果列表构造成指定格式字典.
data_list = [
    (1,'alex',19),
    (2,'老男',84),
    (3,'老女',73)
]

# 请使用推导式将data_list构造生如下格式:
"""
info_dict = {
    1:(1,'alex',19),
    2:(2,'老男',84),
    3:(3,'老女',73)
}
"""
--------------------------
new_dict = { i[0]:(i) for i in data_list }
print(new_dict)
- 有4个人玩扑克牌比大小,请对比字典中每个人的牌的大小,并输入优胜者的姓名(值大的胜利,不必考虑A)。
player = {
    "武沛齐":["红桃",10],
    "alex":["红桃",8],
    'eric':["黑桃",3],
    'killy':["梅花",12],
}
------------------------------------------------
winner = sorted(player.items(), key=lambda x: x[1][-1], reverse=True)[0][0]
print(winner)

data = sorted(player.items(), key=lambda x: x[1][1])[-1][0]
print(data)

new_dict = max(player.items(),key= lambda x: x[1][-1])[0] # 自己写的
print(new_dict)
-
尽量多的列举你记得的内置函数?【能记住多少就写多少,不强制去背,在此尽权利写即可,这种公共后续用的多了就自然而然就记住了】
-
请编写一个生成器函数实现生成n个斐波那契数列的值。
-
什么是斐波那契数列?
-
代码结构示例,请在此基础上补充代码实现。
def fib(max_count):
    pass

count = input("请输入要生成斐波那契数列的个数:")
count = int(count)
fib_generator = fib(count)
for num in fib_generator:
    print(num)
------------------------------------------------------
def fib(max_count):
    first = 1
    second = 0
    count = 0
    while count < max_count:
        next_value = first + second  # 下一个数= 第一个加第二个数
        first = second   # 第二个数进 第一个数
        second = next_value # 下一个数进 给第二个数
        yield next_value #2
        count += 1  #计数


limit_count = input("请输入要生成斐波那契数列的个数:")
limit_count = int(limit_count)
fib_generator = fib(limit_count)
for num in fib_generator:
    print(num)