day11 函数进阶
目标:掌握函数相关易错点 & 项目开发必备技能。
今日概要:
- 参数的补充
- 函数名,函数名到底是什么?
- 返回值和print,傻傻分不清楚。
- 函数的作用域
1.参数的补充
在函数基础部分,我们掌握函数和参数基础知识,掌握这些其实完全就可以进行项目的开发。
今天的补充的内容属于进阶知识,包含:内存地址相关、面试题相关等,在特定情况下也可以让代码更加简洁,提升开发效率。
1.1 参数内存地址相关【面试题】
在开始开始讲参数内存地址相关之前,我们先来学习一个技能:
如果想要查看下某个值的在内存中的地址?
记住一句话:函数执行传参时,传递的是内存地址。
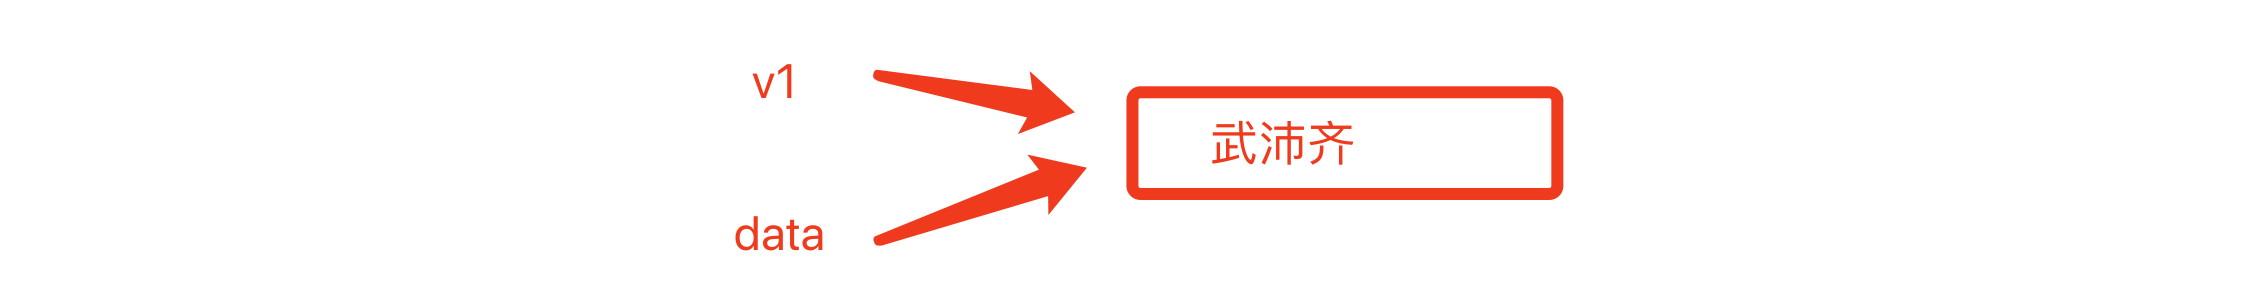
def func(data):
    print(data, id(data))  # 武沛齐  140247057684592


v1 = "武沛齐"
print(id(v1))  # 140247057684592

func(v1)
面试题:请问Python的参数默认传递的是什么?
Python参数的这一特性有两个好处:
-
节省内存
-
对于可变类型且函数中修改元素的内容,所有的地方都会修改。可变类型:列表、字典、集合。
# 可变类型 & 修改内部修改
def func(data):
    data.append(999)

v1 = [11,22,33]
func(v1)

print(v1) # [11,22,33,999]
# 特殊情况:可变类型 & 重新赋值
def func(data):
    data = ["武沛齐","alex"]

v1 = [11,22,33]
func(v1)

print(v1) # [11,22,33]
其他很多编程语言执行函数时,默认传参时会将数据重新拷贝一份,会浪费内存。
提示注意:其他语言也可以通过 ref 等关键字来实现传递内存地址。
当然,如果你不想让外部的变量和函数内部参数的变量一致,也可以选择将外部值拷贝一份,再传给函数。
import copy


# 可变类型 & 修改内部修改
def func(data):
    data.append(999)


v1 = [11, 22, 33]
new_v1 = copy.deepcopy(v1) # 拷贝一份数据
func(new_v1)

print(v1)  # [11,22,33]
1.2 函数的返回值是内存地址
上述代码的执行过程:
- 执行func函数
data = [11, 22, 33]创建一块内存区域,内部存储[11,22,33],data变量指向这块内存地址。return data返回data指向的内存地址- v1接收返回值,所以 v1 和 data 都指向
[11,22,33]的内存地址(两个变量指向此内存,引用计数器为2) - 由函数执行完毕之后,函数内部的变量都会被释放。(即:删除data变量,内存地址的引用计数器-1)
所以,最终v1指向的函数内部创建的那块内存地址。
def func():
    data = [11, 22, 33]
    return data

v1 = func()
print(v1) # [11,22,33]
v2 = func()
print(v2) # [11,22,33]
上述代码的执行过程:
- 执行func函数
data = [11, 22, 33]创建一块内存区域,内部存储[11,22,33],data变量指向这块内存地址 1000001110。return data返回data指向的内存地址- v1接收返回值,所以 v1 和 data 都指向
[11,22,33]的内存地址(两个变量指向此内存,引用计数器为2) - 由函数执行完毕之后,函数内部的变量都会被释放。(即:删除data变量,内存地址的引用计数器-1)
所以,最终v1指向的函数内部创建的那块内存地址。(v1指向的1000001110内存地址)
- 执行func函数
data = [11, 22, 33]创建一块内存区域,内部存储[11,22,33],data变量指向这块内存地址 11111001110。return data返回data指向的内存地址- v2接收返回值,所以 v1 和 data 都指向
[11,22,33]的内存地址(两个变量指向此内存,引用计数器为2) - 由函数执行完毕之后,函数内部的变量都会被释放。(即:删除data变量,内存地址的引用计数器-1)
所以,最终v1指向的函数内部创建的那块内存地址。(v1指向的11111001110内存地址)
def func():
    data = [11, 22, 33]
    print(id(data))
    return data


v1 = func()
print(v1, id(v1))  # [11,22,33]

v2 = func()
print(v2, id(v1))  # [11,22,33]
1.3 参数的默认值【面试题】
这个知识点在面试题中出现的概率比较高,但真正实际开发中用的比较少。
原理:Python在创建函数(未执行)时,如果发现函数的参数中有默认值,则在函数内部会创建一块区域并维护这个默认值。
- 执行函数未传值时,则让a2指向 函数维护的那个值的地址。
- 执行函数传值时,则让a2指向新传入的值的地址。
在特定情况【默认参数的值是可变类型 list/dict/set】 & 【函数内部会修改这个值】下,参数的默认值 有坑 。
- 坑
# 在函数内存中会维护一块区域存储 [1,2,666,666,666] 100010001
def func(a1,a2=[1,2]):
    a2.append(666)
    print(a1,a2)

# a1=100
# a2 -> 100010001
func(100) # 100  [1,2,666]

# a1=200
# a2 -> 100010001
func(200) # 200 [1,2,666,666]

# a1=99
# a2 -> 1111111101
func(99,[77,88]) # 99 [77, 88, 666]

# a1=300
# a2 -> 100010001
func(300) # 300 [1,2,666,666,666]
- 大坑
# 在内部会维护一块区域存储 [1, 2, 10, 20,40 ] ,内存地址 1010101010
def func(a1, a2=[1, 2]):
    a2.append(a1)
    return a2

# a1=10
# a2 -> 1010101010
# v1 -> 1010101010
v1 = func(10)
print(v1) # [1, 2, 10]

# a1=20
# a2 -> 1010101010
# v2 -> 1010101010
v2 = func(20)
print(v2) # [1, 2, 10, 20 ]

# a1=30
# a2 -> 11111111111        [11, 22,30]
# v3 -> 11111111111
v3 = func(30, [11, 22])
print(v3) #  [11, 22,30]

# a1=40
# a2 -> 1010101010
# v4 -> 1010101010
v4 = func(40)
print(v4) # [1, 2, 10, 20,40 ]
- 深坑
# 内存中创建空间存储 [1, 2, 10, 20, 40] 地址:1010101010
def func(a1, a2=[1, 2]):
    a2.append(a1)
    return a2

# a1=10
# a2 -> 1010101010
# v1 -> 1010101010
v1 = func(10)
print(v1) #[1,2,10]

# a1=20
# a2 -> 1010101010
# v2 -> 1010101010
v2 = func(20)

# a1=30
# a2 -> 11111111111   [11,22,30]
# v3 -> 11111111111
v3 = func(30, [11, 22])

# a1=40
# a2 -> 1010101010
# v4 -> 1010101010
v4 = func(40)

print(v1) # [1, 2, 10, 20, 40]
print(v2) # [1, 2, 10, 20, 40]
print(v3) # [11,22,30]
print(v4) # [1, 2, 10, 20, 40]
1.4 动态参数
动态参数,定义函数时在形参位置用 *或** 可以接任意个参数。
在定义函数时可以用 *和**,其实在执行函数时,也可以用。
- 形参固定,实参用
*和**
def func(a1,a2):
    print(a1,a2)

func( 11, 22 )
func( a1=1, a2=2 )

func( *[11,22] )
func( **{"a1":11,"a2":22} )
- 形参用
*和**,实参也用*和**
def func(*args,**kwargs):
    print(args,kwargs)

func( 11, 22 )
func( 11, 22, name="武沛齐", age=18 )

# 小坑,([11,22,33], {"k1":1,"k2":2}), {}
func( [11,22,33], {"k1":1,"k2":2} )

# args=(11,22,33),kwargs={"k1":1,"k2":2}
func( *[11,22,33], **{"k1":1,"k2":2} )

# 值得注意:按照这个方式将数据传递给args和kwargs时,数据是会重新拷贝一份的(可理解为内部循环每个元素并设置到args和kwargs中)。
所以,在使用format字符串格式化时,可以可以这样:
v1 = "我是{},年龄:{}。".format("武沛齐",18)
v2 = "我是{name},年龄:{age}。".format(name="武沛齐",age=18)


v3 = "我是{},年龄:{}。".format(*["武沛齐",18])
v4 = "我是{name},年龄:{age}。".format(**{"name":"武沛齐","age":18})
练习题
- 看代码写结果
def func(*args,**kwargs):
    print(args,kwargs)

params = {"k1":"v2","k2":"v2"}
func(params)    # ({"k1":"v2","k2":"v2"}, ) {}
func(**params)  # (), {"k1":"v2","k2":"v2"}
- 读取文件中的 URL 和 标题,根据URL下载视频到本地(以标题作为文件名)。
模仿,https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0300f570000bvbmace0gvch7lo53oog&ratio=720p&line=0
卡特,https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f3e0000bv52fpn5t6p007e34q1g&ratio=720p&line=0
罗斯,https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f240000buuer5aa4tij4gv6ajqg&ratio=720p&line=0
# 下载视频示例
import requests

res = requests.get(
    url="https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f240000buuer5aa4tij4gv6ajqg&ratio=720p&line=0",
    headers={
        "user-agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36 FS"
    }
)
with open('rose.mp4', mode='wb') as f:
    f.write(res.content)
import requests
import os
# # 定位文件位置
base_dir = os.path.dirname(os.path.abspath(__file__))
file_path = os.path.join(base_dir,'files/oo.csv')
mp4_path = os.path.join(base_dir,'files')
# 下载
def download(title,url):
    # 下载文件
    res = requests.get(
        url=url,
        headers={
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36 FS"
        }
    )
    with open('{}{}.mp4'.format(mp4_path,title), mode='wb') as f_w:
        f_w.write(res.content)

#读取文件
with open(file_path,mode='r',encoding='utf-8') as f_r:
    for line in f_r:
        row_list = line.strip().split(',')
        print(row_list)
        # uname =os.path.join(mp4_path,'{}.mp4'.format(uname))
        download(*row_list)
2. 函数和函数名
函数名其实就是一个变量,这个变量只不过代指的函数而已。
注意:函数必须先定义才能被调用执行(解释型语言)。
2.1 函数做元素
既然函数就相当于是一个变量,那么在列表等元素中是否可以把行数当做元素呢?
def func():
    return 123

data_list = ["武沛齐", "func", func , func() ]

print( data_list[0] ) # 字符串"武沛齐"
print( data_list[1] ) # 字符串 "func"
print( data_list[2] ) # 函数 func
print( data_list[3] ) # 整数 123

res = data_list[2]()
print( res ) # 执行函数 func,并获取返回值;print再输出返回值。

print( data_list[2]() ) # 123
注意:函数同时也可被哈希,所以函数名通知也可以当做 集合的元素、字典的键。
掌握这个知识之后,对后续的项目开发有很大的帮助,例如,在项目中遇到根据选择做不同操作时:
- 情景1,例如:要开发一个类似于微信的功能。
def send_message():
    """发送消息"""
    pass

def send_image():
    """发送图片"""
    pass

def send_emoji():
    """发送表情"""
    pass

def send_file():
    """发送文件"""
    pass

print("欢迎使用xx系统")
print("请选择:1.发送消息;2.发送图片;3.发送表情;4.发送文件")
choice = input("输入选择的序号")

if choice == "1":
    send_message()
elif choice == "2":
    send_image()
elif choice == "3":
    send_emoji()
elif choice == "4":
    send_file()
else:
    print("输入错误")
def send_message():
    """发送消息"""
    pass


def send_image():
    """发送图片"""
    pass


def send_emoji():
    """发送表情"""
    pass


def send_file():
    """发送文件"""
    pass

def xxx():
    """收藏"""
    pass


function_dict = {
    "1": send_message,
    "2": send_image,
    "3": send_emoji,
    "4": send_file,
    "5": xxx
}

print("欢迎使用xx系统")
print("请选择:1.发送消息;2.发送图片;3.发送表情;4.发送文件")
choice = input("输入选择的序号") # "1"

func = function_dict.get(choice)
if not func:
    print("输入错误")
else:
    # 执行函数
    func()
- 情景2,例如:某个特定情况,要实现发送短信、微信、邮件。
def send_msg():
    """发送短信"""
    pass

def send_email():
    """发送图片"""
    pass

def send_wechat():
    """发送微信"""

# 执行函数
send_msg()
send_email()
send_wechat()
def send_msg():
    """发送短信"""
    pass

def send_email():
    """发送图片"""
    pass

def send_wechat():
    """发送微信"""
    pass


func_list = [ send_msg, send_email, send_wechat ]
for item in func_list:
    item()
上述两种情景,在参数相同时才可用,如果参数不一致,会出错。所以,在项目设计时就要让程序满足这一点,如果无法满足,也可以通过其他手段实现,例如:
情景1:
def send_message(phone,content):
    """发送消息"""
    pass


def send_image(img_path, content):
    """发送图片"""
    pass


def send_emoji(emoji):
    """发送表情"""
    pass


def send_file(path):
    """发送文件"""
    pass


function_dict = {
    "1": [ send_message,  ['15131255089', '你好呀']],
    "2": [ send_image,  ['xxx/xxx/xx.png', '消息内容']],
    "3": [ send_emoji, ["😁"]],
    "4": [ send_file, ['xx.zip'] ]
}

print("欢迎使用xx系统")
print("请选择:1.发送消息;2.发送图片;3.发送表情;4.发送文件")
choice = input("输入选择的序号") # 1

item = function_dict.get(choice) # [ send_message,  ['15131255089', '你好呀']],
if not item:
    print("输入错误")
else:
    # 执行函数
    func = item[0] # send_message
    param_list = item[1] #  ['15131255089', '你好呀']

    func(*param_list) # send_message(*['15131255089', '你好呀'])
情景2:
def send_msg(mobile, content):
    """发送短信"""
    pass


def send_email(to_email, subject, content):
    """发送图片"""
    pass


def send_wechat(user_id, content):
    """发送微信"""
    pass


func_list = [
    {"name": send_msg, "params": {'mobile': "15131255089", "content": "你有新短消息"}},
    {"name": send_email, "params": {'to_email': "wupeiqi@live.com", "subject": "报警消息", "content": "硬盘容量不够用了"}},
    {"name": send_wechat, "params": {'user_id': 1, 'content': "约吗"}},
]

#  {"name": send_msg, "params": {'mobile': "15131255089", "content": "你有新短消息"}},
for item in func_list:
    func = item['name'] # send_msg
    param_dict = item['params'] # {'mobile': "15131255089", "content": "你有新短消息"}
    func(**param_dict) # send_msg(**{'mobile': "15131255089", "content": "你有新短消息"})
2.2 函数名赋值
- 将函数名赋值给其他变量,函数名其实就个变量,代指某函数;如果将函数名赋值给另外一个变量,则此变量也会代指该函数,例如:
def func(a1,a2):
    print(a1,a2)

func_list = [func,func,func]

func(11,22)
func_list[0](11,22)
func_list[1](33,44)
func_list[2](55,66)
- 对函数名重新赋值,如果将函数名修改为其他值,函数名便不再代指函数,例如:
注意:由于函数名被重新定义之后,就会变量新被定义的值,所以大家在自定义函数时,不要与python内置的函数同名,否则会覆盖内置函数的功能,例如:
# len内置函数用于计算值得长度
v1 = len("武沛齐")
print(v1) # 3

# len重新定义成另外一个函数
def len(a1,a2):
    return a1 + a2

# 以后执行len函数,只能按照重新定义的来使用
v3 = len(1,2)
print(v3)
2.3 函数名做参数和返回值
函数名其实就一个变量,代指某个函数,所以,他和其他的数据类型一样,也可以当做函数的参数和返回值。
- 参数
def plus(num):
    return num + 100

def handler(func):
    res = func(10) # 110
    msg = "执行func,并获取到的结果为:{}".format(res)
    print(msg) # 执行func,并获取到的结果为:110

# 执行handler函数,将plus作为参数传递给handler的形式参数func
handler(plus)
- 返回值
def plus(num):
    return num + 100

def handler():
  print("执行handler函数")
    return plus

result = handler()
data = result(20) # 120
print(data)
3.返回值和print
对于初学者的同学,很多人都对print和返回值分不清楚,例如:
def add(n1,n2):
    print(n1 + n2)

v1 = add(1,3)
print(v1)

# 输出
4
None


def plus(a1,a2):
    return a1 + a2

v2 = plus(1,2)
print(v2)
# 输出
3
这两个函数是完全不同的
- 在函数中使用print,只是用于在某个位置输出内容而已。
- 在函数中使用return,是为了将函数的执行结果返回给调用者,以便于后续其他操作。
在调用并执行函数时,要学会分析函数的执行步骤。
def f1():
    print(123)


def f2(arg):
    ret = arg()
    return f1


v1 = f2(f1)

v2 = v1()
print(v2)

# 输出
123
123
None
4. 作用域
作用域,可以理解为一块空间,这块空间的数据是可以共享的。通俗点来说,作用域就类似于一个房子,房子中的东西归里面的所有人共享,其他房子的人无法获取。
4.1 函数为作用域
Python以函数为作用域,所以在函数内创建的所有数据,可以此函数中被使用,无法在其他函数中被使用。
def func():
    name = "武沛齐"
    data_list = [11,22,33,44]
    print(name,data_list)
    age = 20
    print(age)

def handler():
    age = 18
    print(age)

func()
handler()
学会分析代码,了解变量到底属于哪个作用域且是否可以被调用:
def func():
    name = "武沛齐"
    age = 29
    print(age)
    data_list = [11,22,33,44]
    print(name,data_list)

    for num in range(10):
        print(num)

    print(num)

    if 1 == 1:
        value = "admin"
        print(value)
    print(value)

    if 1 > 2:
        max_num = 10
        print(max_num)
    print(max_num)


def handler():
    age = 18
    print(age)

handler()
func()
4.2 全局和局部
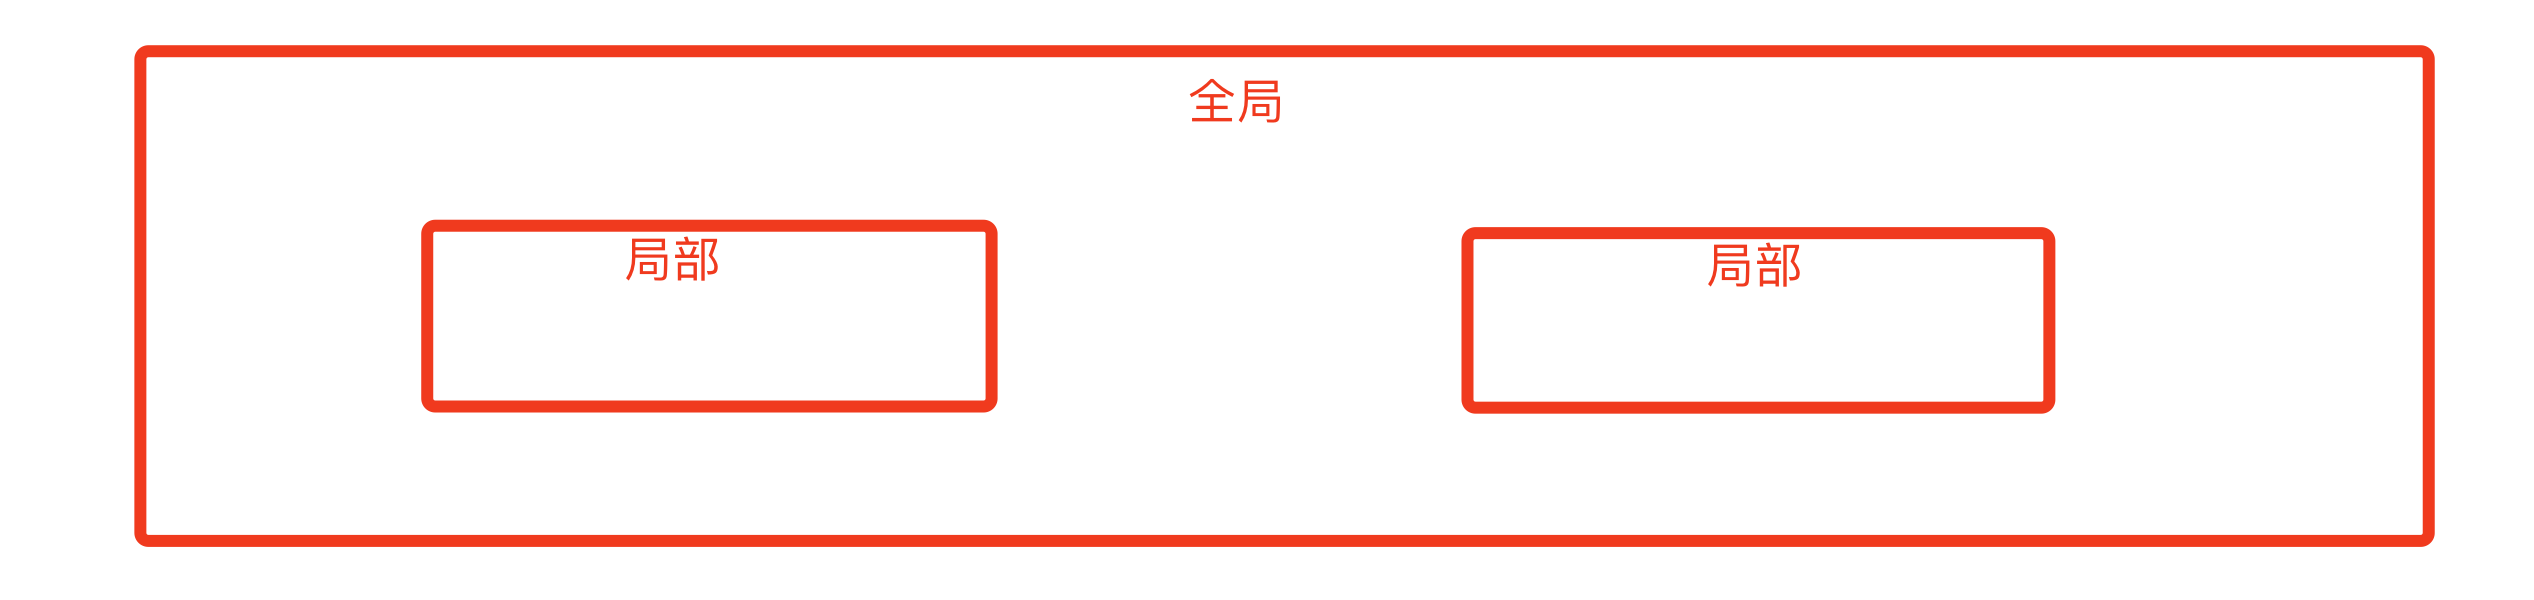
Python中以函数为作用域,函数的作用域其实是一个局部作用域。
goods = [
    {"name": "电脑", "price": 1999},
    {"name": "鼠标", "price": 10},
    {"name": "游艇", "price": 20},
    {"name": "美女", "price": 998}
]
for index in range(len(goods)):
    item = goods[index]
    print(index + 1, item['name'], item['price'])

while True:
    num = input("请输入要选择的商品序号(Q/q):")  # "1"
    if num.upper() == "Q":
        break
    if not num.isdecimal():
        print("用输入的格式错误")
        break
    num = int(num)
    send_email()
    if num > 4 or num < 0:
        print("范围选择错误")
        break
    target_index = num - 1
    choice_item = goods[target_index]
    print(choice_item["name"], choice_item['price'])
    send_email()
# 全局变量(变量名大写)
COUNTRY = "中国"
CITY_LIST = ["北京","上海","深圳"]

def download():
    # 局部变量
    url = "http://www.xxx.com"
    ...

def upload():
    file_name = "rose.zip"
    ...
COUNTRY和CITY_LIST是在全局作用域中,全局作用域中创建的变量称之为【全局变量】,可以在全局作用域中被使用,也可以在其局部作用域中被使用。
download和upload函数内部维护的就是一个局部作用域,在各自函数内部创建变量称之为【局部变量】,且局部变量只能在此作用域中被使用。局部作用域中想使用某个变量时,寻找的顺序为:优先在局部作用域中寻找,如果没有则去上级作用域中寻找。
注意:全局变量一般都是大写。
示例1:在局部作用域中读取全局作用域的变量。
COUNTRY = "中国"
CITY_LIST = ["北京","上海","深圳"]

def download():
    url = "http://www.xxx.com"
    print(url)
    print(COUNTRY)
    print(CITY_LIST)

def upload():
    file_name = "rose.zip"
    print(file_name)
    print(COUNTRY)
    print(CITY_LIST)

print(COUNTRY)
print(CITY_LIST)
downlowd()
upload()

print(file_name) # 报错
print(url) # 报错
示例2:局部作用域和全局作用域变量同名,这算啥?
COUNTRY = "中国"
CITY_LIST = ["北京","上海","深圳"]

def download():
    url = "http://www.xxx.com"
    CITY_LIST = ["河北","河南","山西"]
    print(url)
    print(COUNTRY)
    print(CITY_LIST)

def upload():
    file_name = "rose.zip"
    print(COUNTRY)
    print(CITY_LIST)

print(COUNTRY)
print(CITY_LIST)
download()
upload()

COUNTRY = "中华人民共和共国"
CITY_LIST = [11,22,33]

download()
upload()

# 输出
中国
["北京","上海","深圳"]
http://www.xxx.com
中国
["河北","河南","山西"]
中国
 ["北京","上海","深圳"]
http://www.xxx.com
中华人民共和共国
["河北","河南","山西"]
中华人民共和共国
[11,22,33]
4.3 global关键字
默认情况下,在局部作用域对全局变量只能进行:读取和修改内部元素(可变类型),无法对全局变量进行重新赋值。
- 读取
COUNTRY = "中国"
CITY_LIST = ["北京","上海","深圳"]

def download():
    url = "http://www.xxx.com"
    print(COUNTRY)
    print(CITY_LIST)

download()
- 修改内部元素(可变类型)
COUNTRY = "中国"
CITY_LIST = ["北京","上海","深圳"]

def download():
    url = "http://www.xxx.com"
    print(CITY_LIST)

    CITY_LIST.append("广州")
    CITY_LIST[0] = "南京"
    print(CITY_LIST)

download()

#输出
['北京', '上海', '深圳']
['南京', '上海', '深圳', '广州']
- 无法对全局变量重新赋值
COUNTRY = "中国"
CITY_LIST = ["北京","上海","深圳"]

def download():
    url = "http://www.xxx.com"
    # 不是对全部变量赋值,而是在局部作用域中又创建了一个局部变量 CITY_LIST 。
    CITY_LIST =  ["河北","河南","山西"]
    print(CITY_LIST)

def upload():
    file_name = "rose.zip"
    print(COUNTRY)
    print(CITY_LIST)

download()
#['河北', '河南', '山西']
upload()
#中国
#['北京', '上海', '深圳']
如果想要在局部作用域中对全局变量重新赋值,则可以基于 global关键字实现,例如:
COUNTRY = "中国"
CITY_LIST = ["北京","上海","深圳"]

def download():
    url = "http://www.xxx.com"

    global CITY_LIST
    CITY_LIST =  ["河北","河南","山西"]
    print(CITY_LIST)

    global COUNTRY
    COUNTRY = "中华人民共和国"
    print(COUNTRY)

def upload():
    file_name = "rose.zip"
    print(COUNTRY)
    print(CITY_LIST)

download()
upload()
总结
- 函数参数传递的是内存地址。
-
想重新创建一份数据再传递给参数,可以手动拷贝一份。
-
特殊:参数是动态参数时,通过或*传参时,会将数据循环添加到参数中(类似于拷贝一份)
- 函数的返回值也是内存地址。(函数执行完毕后,其内部的所有变量都会被销毁,引用计数器为0时,数据也销毁)
- 当函数的参数有默认值 & 默认值是可变类型 & 函数内部会修改内部元素(有坑)
-
定义函数写形式参数时可以使用
*和**,执行函数时也可以使用。 -
函数名其实也是个变量,他也可以做列表、字典、集合等元素(可哈希)
-
函数名可以被重新赋值,也可以做另外一个函数的参数和返回值。
-
掌握 print 和 return的区别,学会分析代码的执行流程。
-
python是以函数为作用域。
-
在局部作用域中寻找某数据时,优先用自己的,自己没有就在上级作用域中寻找。
-
基于 global关键字可以在局部作用域中实现对全局作用域中的变量(全局变量)重新赋值。
作业
- 如何查看一个值得内存地址?
- 函数的参数传递的是引用(内存地址)还是值(拷贝一份)?
- 看代码写结果
- 看代码写结果
def func(k,v,info={}):
    info[k] = v
    return info

v1 = func(1,2)
print(v1)  # {1: 2}

v2 = func(4,5,{})
print(v2)   # {4: 5}

v3 = func(5,6)
print(v3)   # {1: 2, 5: 6}
- 看代码写结果
def func(k,v,info={}):
    info[k] = v
     return info

v1 = func(1,2)
v2 = func(4,5,{})
v3 = func(5,6)

print(v1,v2,v3)  # {1: 2, 5: 6}   {4: 5}   {1: 2, 5: 6}
- 简述第5题、第6题的结果为何结果不同。
第5题中的 v1和v3变量指向的都是函数内部维护的那个列表的内存地址。
    先print(v1)时,函数内部维护的列表的值当时是{1: 2}
    最后print(v3)时,函数内部维护的列表的值已被修改为{1: 2, 5: 6}

第5题中的 v1和v3变量也是指向的都是函数内部维护的那个列表的内存地址。
    最后再print v1和v3 时,结果就是最终函数内部维护的列表的值,即: {1: 2, 5: 6}
- 看代码写结果
def func(*args, **kwargs):
    print(args, kwargs)
    return "完毕"


v1 = func(11, 22, 33)  # (11, 22, 33) {}
print(v1)  # 完毕

v2 = func([11, 22, 33])  # ([11, 22, 33],) {}
print(v2)  # 完毕

v3 = func(*[11, 22, 33])  # (11, 22, 33) {}
print(v3)  # 完毕

v4 = func(k1=123, k2=456)  # () {'k1': 123, 'k2': 456}
print(v4)  # 完毕

v5 = func({"k1": 123, "k2": 456})  # ({'k1': 123, 'k2': 456},) {}
print(v5)  # 完毕

v6 = func(**{"k1": 123, "k2": 456})  # () {'k1': 123, 'k2': 456}
print(v6)  # 完毕

v7 = func([11, 22, 33], **{"k1": 123, "k2": 456})  # ([11, 22, 33],) {'k1': 123, 'k2': 456}
print(v7)  # 完毕

v8 = func(*[11, 22, 33], **{"k1": 123, "k2": 456})  # (11, 22, 33) {'k1': 123, 'k2': 456}
print(v8)  # 完毕
- 看代码写结果
def func(*args, **kwargs):
    prev = "-".join(args)
    data_list = []
    for k, v in kwargs.items():
        item = "{}-{}".format(k, v)
        data_list.append(item)
        content = "*".join(data_list)
    return prev, content


v1 = func("北京", "上海", city="深圳", count=99)
print(v1)  # ('北京-上海', 'city-深圳*count-99')

v2 = func(*["北京", "上海"], **{"city": "深圳", "count": 99})
print(v2)  # ('北京-上海', 'city-深圳*count-99')
- 补充代码,实现获取天气信息并按照指定格式写入到文件中。
# 获取天气信息示例
import requests
res = requests.get(url="http://www.weather.com.cn/data/ks/101010100.html")
res.encoding = "utf-8"
weather_dict = res.json()

# 获取的天气信息是个字典类型,内容如下:
print(weather_dict)

"""
{
 'weatherinfo': {
     'city': '北京',
     'cityid': '101010100',
     'temp': '18',
     'WD': '东南风',
     'WS': '1级',
     'SD': '17%',
     'WSE': '1',
     'time': '17:05',
     'isRadar': '1',
     'Radar': 'JC_RADAR_AZ9010_JB',
     'njd': '暂无实况',
     'qy': '1011',
     'rain': '0'
 }
}
"""
import requests


def write_file(**kwargs):
    """将天气信息拼接起来,并写入到文件
    格式要求:
     1. 每个城市的天气占一行
     2. 每行的格式为:city-北京,cityid-101010100,temp-18...
    """
    # 补充代码


def get_weather(code):
    """ 获取天气信息 """
    url = "http://www.weather.com.cn/data/ks/{}.html".format(code)
    res = requests.get(url=url)
    res.encoding = "utf-8"
    weather_dict = res.json()
    return weather_dict


city_list = [
    {'code': "101020100", 'title': "上海"},
    {'code': "101010100", 'title': "北京"},
]

# 补充代码
#自写答案
import requests
import os

base_dir = os.path.dirname(os.path.abspath(__file__))

def write_file(**kwargs):
    """将天气信息拼接起来,并写入到文件
    格式要求:
     1. 每个城市的天气占一行
     2. 每行的格式为:city-北京,cityid-101010100,temp-18...
    """
    # 补充代码
    line = []
    for key,val in kwargs.items():
        line.append('{}-{}'.format(key,val))
    line=','.join(line)
    with open('{}/files/weather.txt'.format(base_dir),mode='a',encoding='utf-8') as f_w:
        f_w.write('{}\n'.format(line))

def get_weather(code):
    """ 获取天气信息 """
    url = "http://www.weather.com.cn/data/ks/{}.html".format(code)
    res = requests.get(url=url)
    res.encoding = "utf-8"
    weather_dict = res.json()
    return weather_dict


city_list = [
    {'code': "101020100", 'title': "上海"},
    {'code': "101010100", 'title': "北京"},
]

# 补充代码

for line in city_list:
    weather_dict = get_weather(line.get('code'))['weatherinfo']
    print(weather_dict)
    write_file(**weather_dict)
import requests


def write_file(**kwargs):
    data_list = []

    row_dict = kwargs["weatherinfo"]
    for k, v in row_dict.items():
        group = "{}-{}".format(k, v)
        data_list.append(group)
    row_string = ",".join(data_list)

    with open('xxxx.txt', mode='a', encoding="utf-8") as file_object:
        file_object.write("{}\n".format(row_string))


def get_weather(code):
    url = "http://www.weather.com.cn/data/ks/{}.html".format(code)
    res = requests.get(url=url)
    res.encoding = "utf-8"
    weather_dict = res.json()
    return weather_dict


city_list = [
    {'code': "101020100", 'title': "上海"},
    {'code': "101010100", 'title': "北京"},
]

for item in city_list:
    # 101020100
    result_dict = get_weather(item["code"])
    write_file(**result_dict)
-
看代码写结果
def func(): return 1, 2, 3 val = func() print( type(val) == tuple) # True print( type(val) == list) # False print( type(val) == dict) # False -------------------------- info = { "1": [11, 22, 33], "2": {'k1': 123, "k2": 456, "k3": "999"} } index = input("请输入序号:") value = info[index] if type(value) == list: print(value[0], value[1], value[2]) elif type(value) == dict: print(value['k1'], value['k2'], value['k3']) -
看代码写结果
-
看代码写结果
-
看代码写结果
-
看代码写结果
-
分析代码,写结果:
def func(handler, **kwargs): # handler() -> killer() # kwargs = {"name": "武沛齐", "age": 18} extra = { "code": 123, "name": "武沛齐" } kwargs.update(extra) # kwargs = {"name": "武沛齐", "age": 18,"code": 123,} return handler(**kwargs) def something(**kwargs): return len(kwargs) def killer(**kwargs): # {"name": "武沛齐", "age": 18,"code": 123,} key_list = [] for key in kwargs.keys(): key_list.append(key) return key_list # ["name","age","code"] v1 = func(something, k1=123, k2=456) print(v1) # 4 v2 = func(killer, **{"name": "武沛齐", "age": 18}) print(v2) # ["name","age","code"] -
两个结果输出的分别是什么?并简述其原因。
-
看代码结果
-
看代码结果
-
看代码写结果
-
看代码写结果
-
根据要求实现资源下载器。
-
启动后,让用户选择专区,每个专区用单独的函数实现,提供的专区如下:
-
下载 花瓣网图片专区
- 下载 抖音短视频专区
-
下载 NBA锦集 专区
-
在用户选择了某个功能之后,表示进入某下载专区,在里面循环提示用户可以下载的内容选项(已下载过的则不再提示下载) 提醒:可基于全部变量保存已下载过得资源。
-
在某个专区中,如果用户输入(Q/q)表示 退出上一级,即:选择专区。
-
在选择专区如果输入Q/q则退出整个程序。
-
每个专区实现下载的案例如下:
-
图片
# 可供用户下载的图片如下
image_dict = {
    "1":("吉他男神","https://hbimg.huabanimg.com/51d46dc32abe7ac7f83b94c67bb88cacc46869954f478-aP4Q3V"),
    "2":("漫画美女","https://hbimg.huabanimg.com/703fdb063bdc37b11033ef794f9b3a7adfa01fd21a6d1-wTFbnO"),
    "3":("游戏地图","https://hbimg.huabanimg.com/b438d8c61ed2abf50ca94e00f257ca7a223e3b364b471-xrzoQd"),
    "4":("alex媳妇","https://hbimg.huabanimg.com/4edba1ed6a71797f52355aa1de5af961b85bf824cb71-px1nZz"),
}
# 下载图片示例 import request res = requests.get( url="https://hbimg.huabanimg.com/4edba1ed6a71797f52355aa1de5af961b85bf824cb71-px1nZz", headers={ "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36" } ) with open("alex媳妇.png",mode="wb") as f: f.write(res.content) -
短视频
# 可供用户下载的短视频如下
video_dict = {
    "1":{"title":"东北F4模仿秀",'url':"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0300f570000bvbmace0gvch7lo53oog"},
    "2":{"title":"卡特扣篮",'url':"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f3e0000bv52fpn5t6p007e34q1g"},
    "3":{"title":"罗斯mvp",'url':"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f240000buuer5aa4tij4gv6ajqg"},
}
# 下载视频示例 import requests res = requests.get( url="https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f240000buuer5aa4tij4gv6ajqg", headers={ "user-agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36 FS" } ) with open('罗斯mvp.mp4', mode='wb') as f: f.write(res.content) -
NBA
# 可供用户下载的NBA视频如下
nba_dict = {
    "1":{"title":"威少奇才首秀三双","url":"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0300fc20000bvi413nedtlt5abaa8tg&ratio=720p&line=0"},
    "2":{"title":"塔图姆三分准绝杀","url":"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0d00fb60000bvi0ba63vni5gqts0uag&ratio=720p&line=0"}
}
# 下载示例 import requests res = requests.get( url="https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0d00fb60000bvi0ba63vni5gqts0uag&ratio=720p&line=0", headers={ "user-agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36 FS" } ) with open('塔图姆三分准绝杀.mp4', mode='wb') as f: f.write(res.content)
-
# v1.0 版本答案
import os
import requests

# 已下载的资料存入
SELECT_IMAGE = set()
SELECT_VIDEO = set()
SELECT_NBA = set()

# base_path
base_path = os.path.dirname(os.path.abspath(__file__))


def download(file_path, url):
    res = requests.get(
        url=url,
        headers={
            "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36"
        }
    )
    with open(file_path, mode="wb") as f:
        f.write(res.content)


def image_down():
    ''' 可供用户下载的图片如下'''
    image_dict = {
        "1": ("吉他男神", "https://hbimg.huabanimg.com/51d46dc32abe7ac7f83b94c67bb88cacc46869954f478-aP4Q3V"),
        "2": ("漫画美女", "https://hbimg.huabanimg.com/703fdb063bdc37b11033ef794f9b3a7adfa01fd21a6d1-wTFbnO"),
        "3": ("游戏地图", "https://hbimg.huabanimg.com/b438d8c61ed2abf50ca94e00f257ca7a223e3b364b471-xrzoQd"),
        "4": ("alex媳妇", "https://hbimg.huabanimg.com/4edba1ed6a71797f52355aa1de5af961b85bf824cb71-px1nZz"),
    }
    print('进入图片专区 请选择')
    while True:
        text_list = []
        for num, item in image_dict.items():
            if not num in SELECT_IMAGE:
                text_list.append('{}:{} '.format(num, item[0]))
        if text_list:
            text_content = ','.join(text_list)
        else:
            print('都下载完了, 无下载选项')
            break
        print(text_content)
        select_num = input('请输入选择号码 Q/q退出:')
        if select_num.upper() == 'Q':
            return
        if select_num in SELECT_IMAGE:
            print('已下载过, 重新选择')
            continue
        group = image_dict.get(select_num)
        if not group:
            print('序号不存在, 重新选择')

        file_path = '{}/files/{}.png'.format(base_path, image_dict[select_num][0])
        url = image_dict[select_num][1]
        download(file_path, url)
        SELECT_IMAGE.add(select_num)


def video_down():
    # 可供用户下载的短视频如下
    video_dict = {
        "1": {"title": "东北F4模仿秀",
              'url': "https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0300f570000bvbmace0gvch7lo53oog"},
        "2": {"title": "卡特扣篮",
              'url': "https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f3e0000bv52fpn5t6p007e34q1g"},
        "3": {"title": "罗斯mvp",
              'url': "https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f240000buuer5aa4tij4gv6ajqg"}
    }
    print('欢迎短视频专区:')
    while True:
        text_list = []
        for num,item in video_dict.items():
            if not num in SELECT_VIDEO:
                text_list.append('{}:{}'.format(num, item['title']))
        if not text_list:
            print('已经下载完,')
            break
        text_content = ','.join(text_list)
        print(text_content)
        select_num = input('请选择号码 !Q/q退出:')
        if select_num.upper() == 'Q':
            return
        if select_num in SELECT_VIDEO:
            print('已经下载过,重新选择')
            continue
        group = video_dict.get(select_num)
        if not group:
            print('不存在的序号, 重新选择')
            continue

        file_path = os.path.join(base_path,f'files/{group["title"]}.mp4')
        print(file_path)
        url = group['url']
        download(file_path, url)
        SELECT_VIDEO.add(select_num)


def nba_down():
    # 可供用户下载的NBA视频如下
    nba_dict = {
        "1": {"title": "威少奇才首秀三双",
              "url": "https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0300fc20000bvi413nedtlt5abaa8tg&ratio=720p&line=0"},
        "2": {"title": "塔图姆三分准绝杀",
              "url": "https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0d00fb60000bvi0ba63vni5gqts0uag&ratio=720p&line=0"}
    }
    print('欢迎进入nba专区')
    while True:
        text_list = []
        for num, item in nba_dict.items():
            if not num in SELECT_NBA:
                text_list.append(f'{num}:{item["title"]}')
        if not text_list:
            print('都下载完, ')
            break
        text_content = ','.join(text_list)
        print(text_content)
        select_num = input('请选择: Q/q 退出')
        if select_num.upper() == 'Q':
            return
        if select_num in SELECT_NBA:
            print('已下载过, 请重新选择:')
            continue
        group = nba_dict.get(select_num)
        if not group:
            print('不存在的序号,重新选择: ')
            continue
        file_path = os.path.join(base_path, 'files/{}.mp4'.format(group["title"]))
        url = group['url']
        download(file_path, url)
        SELECT_NBA.add(select_num)

print('欢迎进入xxx系统')
menu_dict = {
    '1': image_down,
    '2': video_down,
    '3': nba_down
}
while True:
    print('1:图片专区,2:小视频专区,3:nba专区')
    choice = input('请选择进入的专区: Q/q退出')
    if choice.upper() == "Q":
        break
    func = menu_dict.get(choice)
    if not func:
        print('选择专区不存在,重新选择')
        continue
    # 进入专区
    func()
#v2.0版本
import os
import requests

DB = {
    "1":{
        "area":"花瓣网图片专区",
        "total_dict" : {
            "1":("吉他男神","https://hbimg.huabanimg.com/51d46dc32abe7ac7f83b94c67bb88cacc46869954f478-aP4Q3V"),
            "2":("漫画美女","https://hbimg.huabanimg.com/703fdb063bdc37b11033ef794f9b3a7adfa01fd21a6d1-wTFbnO"),
            "3":("游戏地图","https://hbimg.huabanimg.com/b438d8c61ed2abf50ca94e00f257ca7a223e3b364b471-xrzoQd"),
            "4":("alex媳妇","https://hbimg.huabanimg.com/4edba1ed6a71797f52355aa1de5af961b85bf824cb71-px1nZz"),
                        },
        "ext":'png',
        "selected":set()
    },
    "2":{
        "area":"抖音短视频",
        "total_dict": {
            "1":{"title":"东北F4模仿秀",'url':"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0300f570000bvbmace0gvch7lo53oog"},
            "2":{"title":"卡特扣篮",'url':"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f3e0000bv52fpn5t6p007e34q1g"},
            "3":{"title":"罗斯mvp",'url':"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0200f240000buuer5aa4tij4gv6ajqg"},
                    },
        "ext":'mp4',
        "selected":set()

    },
    "3":{
        "area":"NBA视频",
        "total_dict":{
            "1":{"title":"威少奇才首秀三双","url":"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0300fc20000bvi413nedtlt5abaa8tg&ratio=720p&line=0"},
            "2":{"title":"塔图姆三分准绝杀","url":"https://aweme.snssdk.com/aweme/v1/playwm/?video_id=v0d00fb60000bvi0ba63vni5gqts0uag&ratio=720p&line=0"}
                },
        "ext":"mp4",
        "selected":set()
    }
}

base_dir = os.path.dirname(os.path.abspath(__file__))
# 下载方法
def download(file_path,url):
    res=requests.get(
        url=url,
        headers={
            "user-agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/87.0.4280.88 Safari/537.36 FS"
        }
    )
    with open(file_path,mode='wb') as f:
        f.write(res.content)

def handler(area_dict):
    print(f'欢迎进入{area_dict["area"]}')
    # 打印可下载项目列表
    while True:
        text_list = []
        for num,item in area_dict['total_dict'].items():
            if num in area_dict['selected']:
                continue
            if type(item) == tuple:
                data = f'{num}:{item[0]}'
            else:
                data = f'{num}:{item["title"]}'
            text_list.append(data)
        if not text_list:
            print("无下载选项")
            return
        text_content = ','.join(text_list)
        print(text_content)
        choice = input('请选择下载: Q/q退出')
        if choice.upper() == 'Q':
            return
        if not choice in area_dict["total_dict"]:
            print('不存在的选项,请重新选择')
            continue
        # 提取文件名,下载地址 下载文件
        if type(area_dict['total_dict'][choice]) ==tuple:
            file_name = area_dict['total_dict'][choice][0]+'.png'
            url = area_dict['total_dict'][choice][1]
        if type(area_dict['total_dict'][choice]) == dict:
            file_name = area_dict['total_dict'][choice]["title"]+'.mp4'
            url = area_dict['total_dict'][choice]['url']
        file_path = os.path.join(base_dir,f'files/{file_name}')
        download(file_path,url)
        area_dict['selected'].add(choice)


print("欢迎进入xxx系统")
while True:
    print("1: 豆瓣图片专区,2:短视频专区,3:NBA视频专区")
    choice = input("请选择 Q/q 退出:")
    if choice.upper() == 'Q':
        break
    if not choice in DB:
        print("不存在序号, 请重新选择")
        continue
    area_dict = DB.get(choice)
    handler(area_dict) #进入对应专区